अपना सीवी PDF के रूप में भेजें या Word फ़ाइल के रूप में?
लेखक: Thomas Larsen, Adapt to Success के संस्थापक · · पढ़ने का समय: 9 मिनट
जब मैंने ATS मिथकों पर अपना लेख (एक नए टैब में खुलता है) प्रकाशित किया, तो Jerry Kindall (एक नए टैब में खुलता है) (AI और प्रोडक्ट एक्सपीरियंस के क्षेत्र के एक लीडर) ने LinkedIn पर एक टिप्पणी की, जो मेरे दिमाग़ से निकल ही नहीं पाई। मिथक 4 के नीचे उन्होंने लिखा कि PDF में अक्सर "fi, ffl और अक्षरों के दूसरे संयोजनों के लिए विशेष ग्लिफ़" होते हैं, जो किसी सिस्टम को Office जैसे शब्द को पहचानने से रोक सकते हैं। इसी कारण उन्होंने अपना सीवी Word फ़ाइल के रूप में भेजना शुरू कर दिया था।
अपने 2,200 से ज़्यादा आवेदनों में मैंने हर बार Word से सहेजी गई PDF भेजी थी। उस सीवी से मुझे दो इंटरव्यू मिले, इसलिए मेरे पास यह जानने का एक निजी कारण था कि सॉफ़्टवेयर को असल में फ़ाइल से क्या मिला।
इसलिए सलाह दोहराने के बजाय मैंने इसका परीक्षण किया। पता चला कि Jerry और मैं, दोनों आधे-आधे सही थे, और असली काम की बात बीच वाले हिस्से में है।
छोटा जवाब
बड़े सिस्टम दोनों फ़ॉर्मैट स्वीकार करते हैं। जब तक नौकरी के विज्ञापन में PDF न माँगी जाए, Word फ़ाइल ज़्यादा सुरक्षित विकल्प है, क्योंकि वह आपके टेक्स्ट को सामान्य अक्षरों के रूप में सहेजती है और कुछ नहीं। अगर आप PDF भेजते हैं, तो उसे किसी वेब पेज को PDF में प्रिंट करके नहीं, बल्कि अपने वर्ड प्रोसेसर में Save as PDF से बनाएँ। फ़र्क़ इस बात में नहीं है कि PDF कैसी दिखती है। फ़र्क़ इस बात में है कि जो अक्षर आप देखते हैं, उनके पीछे क्या सहेजा गया है।
सिस्टम ख़ुद क्या कहते हैं
सॉफ़्टवेयर के पीछे की कंपनियाँ आपस में सहमत नहीं हैं। Textkernel, जिसका पार्सर इनमें से कई सिस्टमों के अंदर काम करता है, उस पर अपने प्रोडक्ट बनाने वाली कंपनियों से कहता है: "अगर आप कन्वर्ज़न की समस्याएँ कम से कम रखना चाहते हैं, तो PDF दस्तावेज़ों का इस्तेमाल न करें", और आगे जोड़ता है कि "PDF एक टूटा हुआ मानक है जो अक्सर अंदर के टेक्स्ट की समस्याओं को छिपा देता है" (Textkernel, Getting started (एक नए टैब में खुलता है))। Greenhouse, जो सबसे ज़्यादा इस्तेमाल होने वाले सिस्टमों में से एक है, अपने ही सहायता पेजों पर उम्मीदवारों से इसका उलटा कहता है: "सबसे अच्छे नतीजों के लिए PDF अपलोड करें" (Greenhouse, MyGreenhouse FAQ (एक नए टैब में खुलता है))। Indeed की करियर गाइड बीच का रास्ता अपनाती है: PDF के साथ "इसकी कोई गारंटी नहीं है कि नियोक्ता जिस ATS का इस्तेमाल करता है, वह आपका रिज़्यूमे देख और स्कैन कर सकेगा" (Indeed Career Guide (एक नए टैब में खुलता है))।
बाक़ी सब बातों पर वे सहमत हैं।
PDF के अंदर क्या होता है
Word फ़ाइल आपके सीवी को टेक्स्ट के रूप में सहेजती है: अक्षर, क्रम में, उनके चारों ओर फ़ॉर्मैटिंग के साथ। PDF कुछ ऐसा सहेजती है जो एक चित्र के ज़्यादा क़रीब है। हर अक्षर के लिए वह दर्ज करती है कि कौन-सी आकृति कहाँ बनानी है, और साथ में एक छोटी अनुवाद तालिका अलग से रखती है, जो किसी प्रोग्राम को बताती है कि हर आकृति किन अक्षरों के लिए है। जब कोई पार्सर PDF पढ़ता है, तो वह आकृतियाँ नहीं, बल्कि यही अनुवाद पढ़ता है।
लिगेचर एक ऐसी आकृति है जो दो या तीन अक्षरों की जगह लेती है। कई फ़ॉन्ट में f और i अटपटे ढंग से एक-दूसरे को छूते हैं, इसलिए फ़ॉन्ट में fi के लिए एक तैयार आकृति होती है, fl के लिए दूसरी और ffi के लिए एक और। Unicode, वह मानक जो हर भाषा के हर वर्ण को एक संख्या देता है, इनके लिए अलग कोड तक रखता है (Unicode, Alphabetic Presentation Forms (एक नए टैब में खुलता है))। इससे फ़र्क़ पड़ता है या नहीं, यह पूरी तरह इस पर निर्भर करता है कि अनुवाद तालिका आकृति के पीछे क्या बताती है: सामान्य अक्षर f, f और i, या ffi के लिए एक अकेला कोड।
परीक्षण
7 अक्टूबर 2026 को मैंने एक ऑफ़िस मैनेजर "Alex Fictional" के लिए एक काल्पनिक सीवी बनाया, जिसमें ऐसे 29 शब्द भरे थे जिनमें अक्सर लिगेचर बनते हैं: Office, Officer, efficient, certified, workflow, Affinity, Staffing, traffic, specifications, Qualifications वग़ैरह। मैंने इसे तीन तरीक़ों से PDF में बदला: Microsoft Word (Windows पर Microsoft 365) में Save as PDF, Google Docs में Download as PDF, और Chrome ब्राउज़र में Print to PDF, जो वह तरीक़ा है जिससे कई वेब-आधारित सीवी बिल्डर अपनी फ़ाइलें बनाते हैं। मैंने Chrome में आठ फ़ॉन्ट, Word में Calibri और Aptos, और Google Docs में Calibri, Arial और Georgia इस्तेमाल किए।
फिर मैंने हर फ़ाइल से टेक्स्ट दो बार वापस पढ़ा, एक बार ऐसे रीडर से जो विशेष वर्णों को वापस अक्षरों में बदल देता है, जैसा Adapt to Success करता है, और एक बार ऐसे रीडर से जो टेक्स्ट को ठीक वैसे ही लेता है जैसा वह सहेजा गया है, और 29 शब्दों में से हर एक को खोजा।
मैंने क्या नहीं परखा: Mac पर Word, Canva और दूसरे ऑनलाइन सीवी बिल्डर, और ख़ुद असली सिस्टम, जिनके लिए नियोक्ता का अकाउंट चाहिए। इसलिए यह परीक्षण आपको बताता है कि फ़ाइलों के अंदर क्या है, यह नहीं कि कोई ख़ास ATS उनके साथ क्या करता है।
मुझे क्या मिला
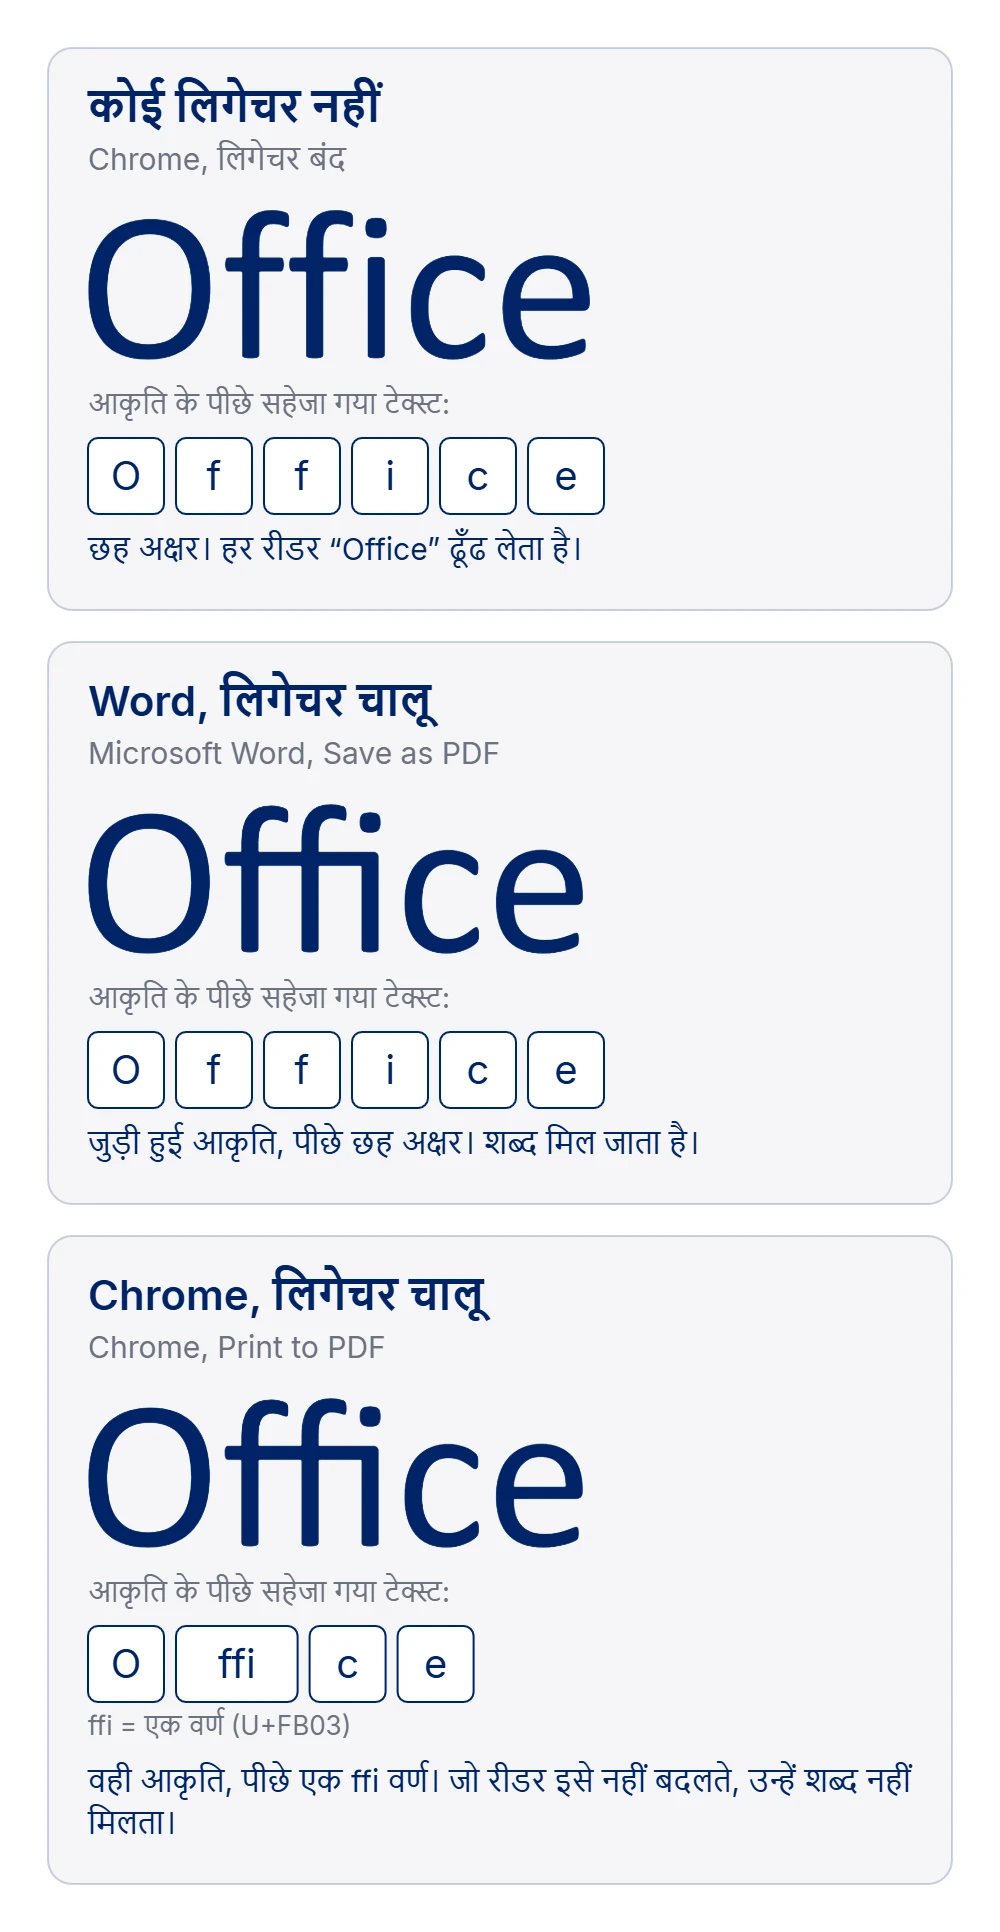
इसे दिखाने के लिए Jerry ने सुझाव दिया था कि लिगेचर के साथ और उसके बिना एक बड़ा "Office" दिखाया जाए। तो यह रहा, एक चीज़ और जोड़कर: आकृति के पीछे सहेजे गए अक्षर।
| PDF कैसे बनाई गई | लिगेचर बने | आकृति के पीछे का टेक्स्ट | बदले बिना मिले | Adapt to Success को मिले |
|---|---|---|---|---|
| Word, डिफ़ॉल्ट सेटिंग (Calibri, Aptos) | नहीं | सामान्य अक्षर | 29 में से 29 | 29 में से 29 |
| Word, लिगेचर चालू (Calibri)* | हाँ | सामान्य अक्षर | 6 में से 6 | 6 में से 6 |
| Google Docs (Calibri, Arial, Georgia) | नहीं | सामान्य अक्षर | 29 में से 29 | 29 में से 29 |
| Chrome, Calibri | हाँ | हर लिगेचर के लिए एक वर्ण | 29 में से 3 | 29 में से 29 |
| Chrome, Aptos | हाँ | हर लिगेचर के लिए एक वर्ण | 29 में से 17 | 29 में से 29 |
| Chrome, छह अन्य फ़ॉन्ट | नहीं | सामान्य अक्षर | 29 में से 29 | 29 में से 29 |
* छह शब्दों वाला एक छोटा परीक्षण दस्तावेज़। Word की डिफ़ॉल्ट सेटिंग में कोई लिगेचर बना ही नहीं।
तीन बातें सामने आती हैं। पहली, Jerry सही थे: जब Word में लिगेचर चालू होते हैं, तो वे PDF तक पहुँचते हैं। जुड़ी हुई आकृति वहाँ होती है। दूसरी, Word उस आकृति के पीछे सामान्य अक्षर सहेजता है, इसलिए मैंने जो भी रीडर आज़माया, उसे शब्द मिल गए। तीसरी, Chrome बिल्कुल वही आकृति बनाता है, लेकिन उसके पीछे एक अकेला ffi वर्ण सहेजता है। जो रीडर टेक्स्ट को वैसे ही लेता है जैसा वह सहेजा गया है, उसे Calibri वाली फ़ाइल में 29 में से 3 शब्द मिले।
यहाँ वही फ़र्क़ उस टेक्स्ट के रूप में है जो एक रीडर को असल में दोनों फ़ाइलों से मिलता है; हर लिगेचर वर्ण एक बॉक्स में दिखाया गया है:
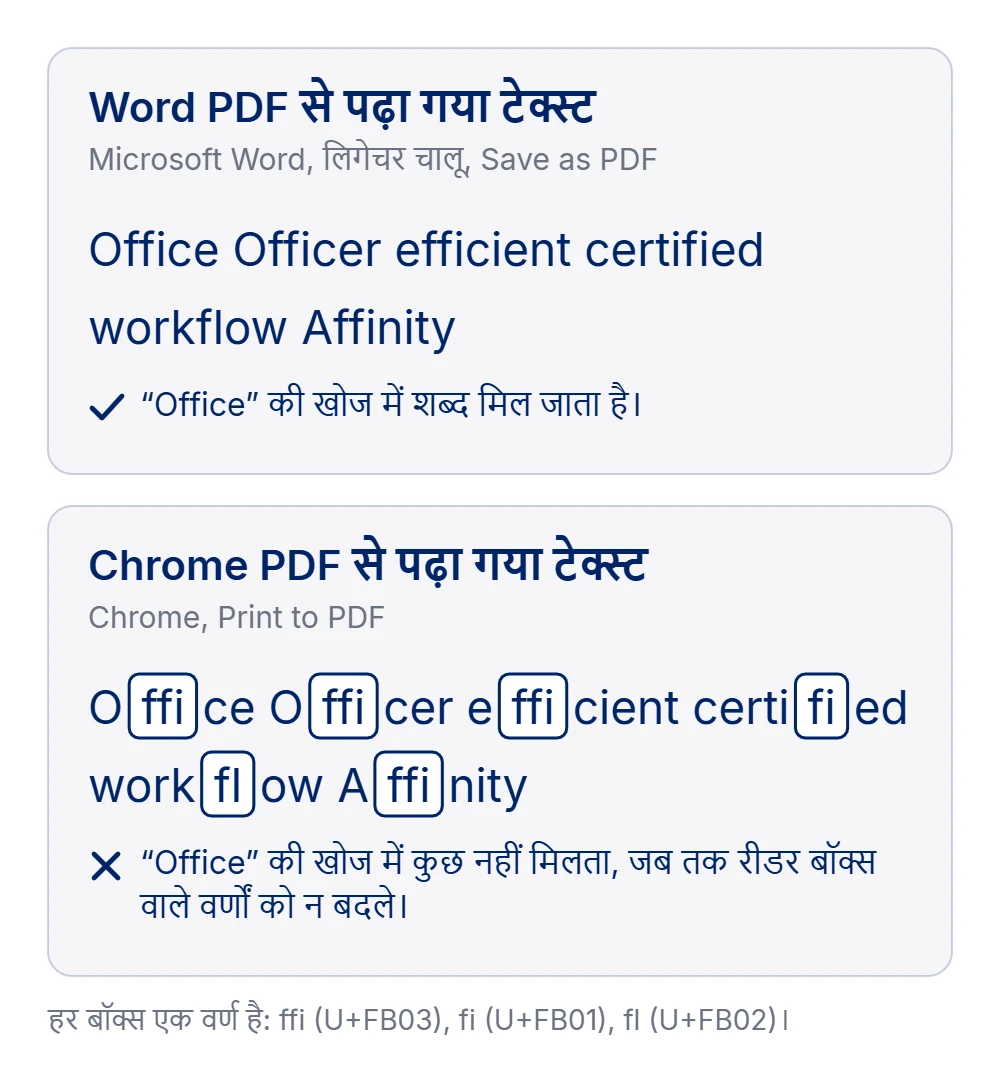
Chrome के साथ न्याय करें तो, वह असली अक्षरों को PDF के एक दूसरे, वैकल्पिक फ़ील्ड में भी सहेजता है, और मैंने जो रीडर आज़माए उनमें से एक को सभी 29 शब्द मिले। नियोक्ता के सिस्टम के अंदर का रीडर भी ऐसा करता है या नहीं, यही पूरा सवाल है।
कौन-से प्रोग्राम इसे वापस अक्षरों में बदलते हैं
Mozilla का pdf.js, जो Firefox के अंदर और Adapt to Success के अंदर चलता है, डिफ़ॉल्ट रूप से नॉर्मलाइज़ करता है; यह तभी रुकता है जब कोई डेवलपर इसे बंद कर दे (pdf.js सोर्स कोड (एक नए टैब में खुलता है))। Apache PDFBox, जिसे कई सर्वर सिस्टम इस्तेमाल करते हैं, यह अपनी पढ़ी हर पंक्ति पर करता है, इस टिप्पणी के साथ कि वह "एकल "fi" लिगेचर को "f" और "i" में बदल देगा" (Apache PDFBox सोर्स कोड (एक नए टैब में खुलता है))। PyMuPDF, जो Python में सीवी पार्सर बनाने वाले डेवलपरों की एक लोकप्रिय पसंद है, डिफ़ॉल्ट रूप से इसका उलटा करता है: लिगेचर "अपने मूल रूप में ही ऐप्लिकेशन तक भेज दिए जाते हैं" (PyMuPDF दस्तावेज़ीकरण (एक नए टैब में खुलता है))। Sensible, एक कंपनी जिसका काम ही PDF से डेटा निकालना है, अपने उपयोगकर्ताओं को चेतावनी देती है कि "भले ही रेंडर किया गया दस्तावेज़ ठीक दिखे, निकाले गए टेक्स्ट में लिगेचर फिर भी मौजूद हो सकते हैं" (Sensible, Ligatures (एक नए टैब में खुलता है))।
किसी नियोक्ता के सिस्टम के अंदर इनमें से कौन-सा है, यह आप बाहर से नहीं देख सकते। यही ईमानदार कारण है कि ऐसी फ़ाइल को तरजीह दी जाए जिसमें यह सवाल उठता ही नहीं।
केवल सॉफ़्टवेयर ही नहीं लड़खड़ाता
स्क्रीन रीडर भी वही टेक्स्ट लेयर पढ़ते हैं। Minnesota IT Services ने Adobe InDesign और Adobe Illustrator में बनी लिगेचर वाली PDF का परीक्षण किया। Illustrator से और InDesign के पुराने संस्करणों से बनी PDF में कैरेक्टर एन्कोडिंग की गड़बड़ियाँ थीं, जबकि परखे गए InDesign के सबसे नए संस्करण में नहीं थीं। Illustrator से बनी एक परीक्षण फ़ाइल में JAWS स्क्रीन रीडर ने "coffee" को "Coee" और "flavor" को "avor" पढ़ा (Minnesota IT Services, 2021 (एक नए टैब में खुलता है))। ब्रिटेन के Department for Transport की अपने कर्मचारियों के लिए गाइडेंस कहती है कि लिगेचर "एक्सेसिबिलिटी की समस्याएँ पैदा कर सकते हैं, ख़ासकर स्क्रीन रीडर के लिए", और कर्मचारियों से Word में Ligatures को None पर सेट करने को कहती है (Department for Transport, 2025 (एक नए टैब में खुलता है))। दोनों में से कोई भी सीवी के बारे में नहीं है, लेकिन स्क्रीन रीडर इस्तेमाल करने वाला रिक्रूटर आपका सीवी इसी तरह पढ़ रहा होता है।
Word फ़ाइलों में भी गड़बड़ हो सकती है
इनमें से कोई भी बात Word फ़ाइल को अपने आप सुरक्षित नहीं बनाती। ऊपर वेंडरों की सूची में लगभग कुछ भी फ़ाइल के प्रकार से जुड़ा नहीं है: एक टेबल, आपके फ़ोन नंबर वाला टेक्स्ट बॉक्स, या दो-कॉलम वाला टेम्पलेट Word में भी वही परेशानी खड़ी करता है जो PDF में। पासवर्ड से सुरक्षित Word फ़ाइल उतनी ही पक्की तरह विफल होती है जितनी लॉक की गई PDF। जिस Word फ़ाइल में आपका नाम टेक्स्ट बॉक्स में हो, वह एक साफ़ PDF से भी बदतर हो सकती है।
सॉफ़्टवेयर को मेरा अपना सीवी कैसा दिखा
यह लिखने से पहले मैंने वह सीवी, जिसे मैंने उन सभी आवेदनों में इस्तेमाल किया था, उन्हीं रीडरों से गुज़ारा। वह Calibri फ़ॉन्ट वाली एक Word फ़ाइल थी, जिसे PDF के रूप में सहेजा गया था, और उसमें एक भी लिगेचर वर्ण नहीं था, इसलिए लिगेचर कभी मेरी समस्या थे ही नहीं। समस्या लेआउट था। दो रीडरों ने एक ही फ़ाइल को दो अलग क्रमों में पढ़ा। pdf.js, जो Firefox और Adapt to Success के अंदर का रीडर है, मेरे फ़ुटर के पेज नंबर "Side 1 af 2" (डेनिश में 2 में से पेज 1, जो एक अंग्रेज़ी सीवी के फ़ुटर में रह गया था) से शुरू हुआ, फिर साइडबार से Ambitions बॉक्स और मेरे संपर्क विवरण पढ़े, और उसके बाद ही मेरा नाम। Xpdf का pdftotext मेरे नाम से शुरू हुआ, लेकिन उसने Ambitions बॉक्स को मेरे कामकाजी इतिहास के बीच में, दो नौकरियों के बीच डाल दिया। एक ही फ़ाइल, दो अलग कहानियाँ, और उनमें से कोई भी वह नहीं थी जो मैंने डिज़ाइन की थी।
आपके लिए इसका क्या मतलब है
जब तक नौकरी के विज्ञापन में PDF न माँगी जाए, Word भेजें। अगर आपको PDF चाहिए, तो उसे Word में Save as PDF से या Google Docs में Download से बनाएँ, किसी वेब पेज या ऑनलाइन सीवी बिल्डर के प्रीव्यू को PDF में प्रिंट करके नहीं। और आप जो भी भेजें, लेआउट सरल रखें: एक कॉलम, असली हेडिंग, आपके संपर्क विवरण पेज के मुख्य हिस्से में। फ़ाइल का प्रकार उतना मायने नहीं रखता जितना उसके अंदर की सामग्री।
एक टिप्पणी क्या कर सकती है
Jerry की टिप्पणी में मेरा एक पूरा दिन लगा, और इस सीरीज़ पर अब तक बिताए दिनों में वह सबसे सार्थक दिन था। सवाल असल में कभी PDF या Word का था ही नहीं। सवाल यह था कि जो अक्षर आप देख सकते हैं, उनके पीछे क्या है, और यह ऐसी चीज़ है जिसे कोई भी पेज देखकर नहीं जाँच सकता।
स्रोत
- Kindall, J. (7 अक्टूबर 2026)। "क्या सचमुच कोई रोबोट आपका सीवी फेंक रहा है?" (एक नए टैब में खुलता है) पर टिप्पणी। LinkedIn। linkedin.com (एक नए टैब में खुलता है)
- Textkernel Developer Documentation। Getting started। Tx Platform v9, Resume Parser। developer.textkernel.com (एक नए टैब में खुलता है)
- Greenhouse Support (2 अक्टूबर 2026 को अद्यतन)। MyGreenhouse FAQ for Candidates। support.greenhouse.io (एक नए टैब में खुलता है)
- Indeed Editorial Team (15 जून 2026 को अद्यतन)। Best Resume File Formats (Plus How To Save Your Document)। Indeed Career Guide। indeed.com (एक नए टैब में खुलता है)
- Greenhouse Support। Unsuccessful resume parse। support.greenhouse.io (एक नए टैब में खुलता है)
- Textkernel Developer Documentation। Document Conversion Code Descriptions। Tx Platform v10, Resume Parser। developer.textkernel.com (एक नए टैब में खुलता है)
- Unicode Consortium। Alphabetic Presentation Forms। The Unicode Standard की कोड तालिका, जिसमें ff, fi, fl, ffi और ffl लिगेचर शामिल हैं। unicode.org (एक नए टैब में खुलता है)
- Unicode Consortium। Unicode Normalization Forms। Unicode Standard Annex #15। unicode.org (एक नए टैब में खुलता है)
- Mozilla। pdf.js, src/display/api.js (getTextContent, disableNormalization, default false)। github.com (एक नए टैब में खुलता है)
- Apache Software Foundation। Apache PDFBox, PDFTextStripper.java (normalizeWord)। github.com (एक नए टैब में खुलता है)
- PyMuPDF दस्तावेज़ीकरण। Constants and Enumerations (TEXT_PRESERVE_LIGATURES)। pymupdf.readthedocs.io (एक नए टैब में खुलता है)
- Sensible दस्तावेज़ीकरण। Ligatures। docs.sensible.so (एक नए टैब में खुलता है)
- DePew, J. (29 सितंबर 2021)। Ligatures: Benefits and Pitfalls। Minnesota IT Services। mn.gov (एक नए टैब में खुलता है)
- Department for Transport (20 फ़रवरी 2025 को अद्यतन)। Use MS Word to create an accessible document। GOV.UK। gov.uk (एक नए टैब में खुलता है)
- Larsen, T. (7 अक्टूबर 2026)। Microsoft Word (Microsoft 365, Windows), Google Docs और Chrome से बनी PDF का अपना परीक्षण, pdf.js 3.11.174 से नॉर्मलाइज़ेशन के साथ और उसके बिना, और Xpdf pdftotext 4.00 से पढ़ा गया। 29 परीक्षण शब्द, आठ फ़ॉन्ट, और वह PDF सीवी जिसे मैंने अपने आवेदनों में इस्तेमाल किया था।